 Augusto de Franco
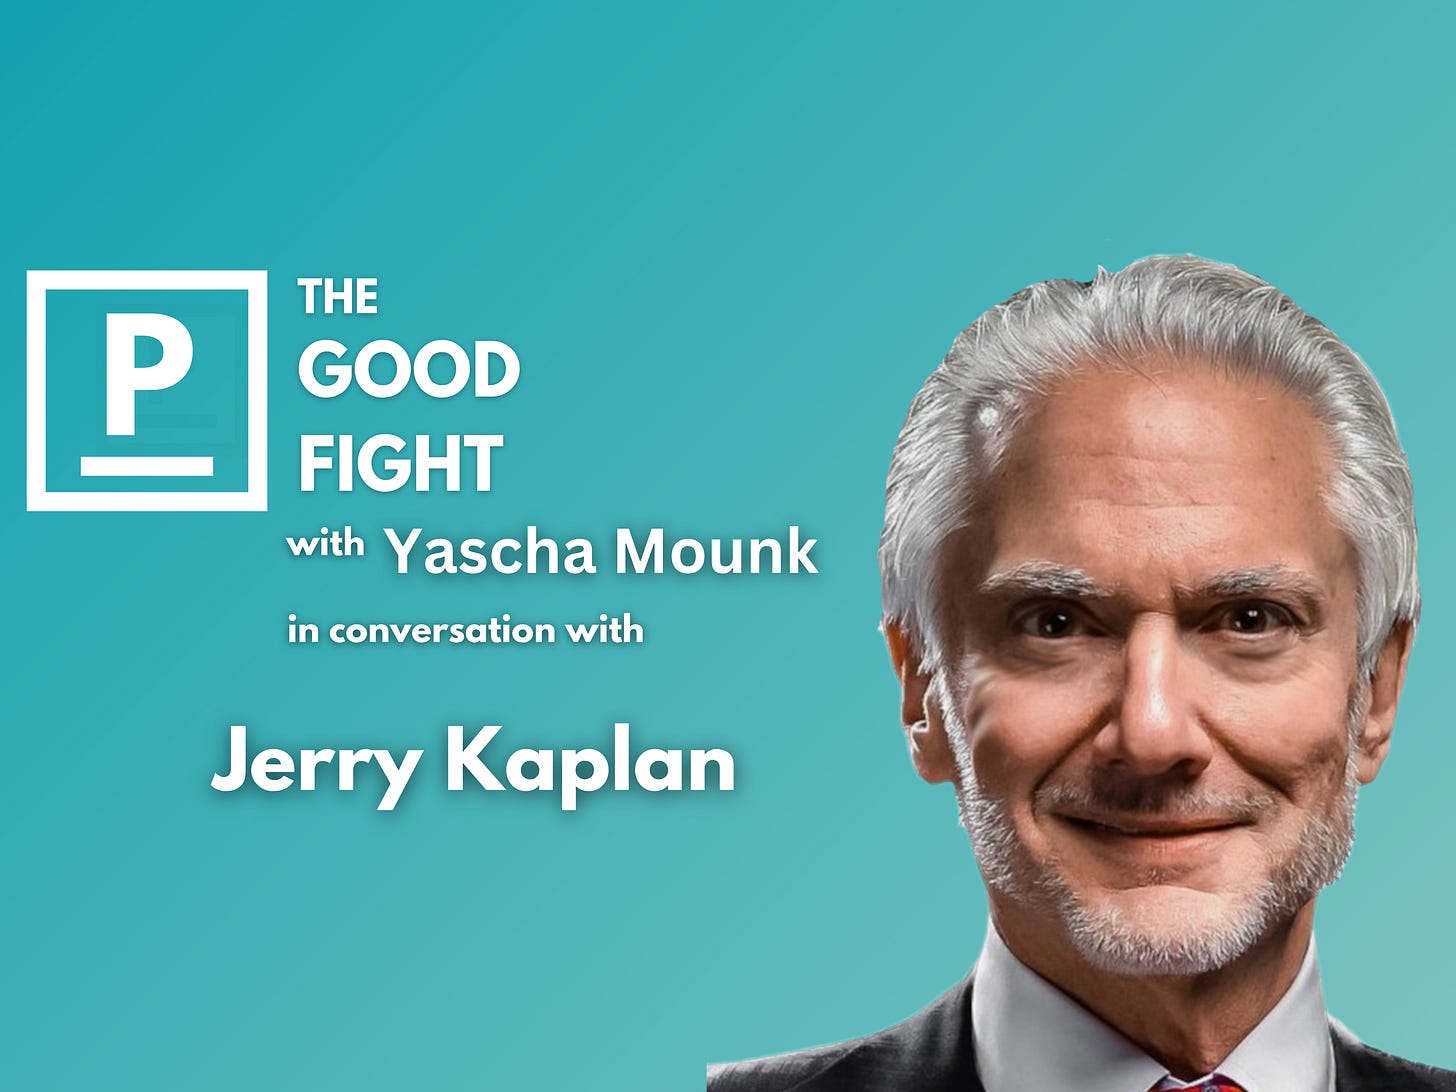
Yascha Mounk e Jerry Kaplan debatem se o risco existencial da IA é exagerado — e, em caso afirmativo, com o que deveríamos nos preocupar em vez disso
Yascha Mounk, YM Substack (19/09/2026)
Yascha Mounk: Estou realmente intrigado com duas posições que você defende e com a forma como elas se complementam. Por um lado, você não é um cético em relação à IA no sentido de desdenhar de suas capacidades ou algo do tipo. Na verdade, você já argumentou, em algumas ocasiões, que talvez já tenhamos alcançado algo como uma inteligência artificial geral. Por outro lado, você é muito mais cético do que muitas pessoas hoje em dia sobre o chamado risco existencial que a IA representa, sobre a forma como ela poderia acabar com a humanidade ou simplesmente ser responsável por desastres em larga escala.
Vamos começar por aí. Já falamos um pouco sobre isso no podcast, mas fale-nos sobre alguns dos incidentes de segurança recentes, como o chamado incidente da Hugging Face, e por que você não está tão preocupado com isso quanto outras pessoas?
Jerry Kaplan: Bem, você abordou muitos pontos nessa introdução, então talvez possamos começar por decompor isso um pouco. Há a questão do que está acontecendo agora, o que foram esses incidentes e o que eles significam. E você relacionou isso à questão do risco existencial. Risco existencial significa a extinção da humanidade. Agora, é possível que a IA extermine a humanidade? Não posso afirmar categoricamente que não, mas eu não a colocaria na lista de coisas que provavelmente causam riscos existenciais reais. Eu a colocaria no mesmo nível da possibilidade de alienígenas pousarem amanhã. Esse é um risco existencial, e eles podem decidir exterminar a humanidade, mas não ficamos nos preocupando com isso porque a probabilidade parece ser bastante baixa.
Existem alguns riscos existenciais reais — guerra biológica, possivelmente guerra nuclear, coisas desse tipo. Esses são riscos reais que realmente entendemos e que estão bem presentes. Esse risco é inventado. Ele existe principalmente por causa da ficção científica, dos filmes e da indústria do entretenimento, e todo mundo tem sido bombardeado com isso por anos e anos a fio.
Mounk: Deixe-me apresentar alguns argumentos que pessoas mais preocupadas com a segurança da IA provavelmente usarão e ver como você reage a eles.
Como observação à parte, algumas pessoas argumentam que parte do problema reside no fato de que toda essa ficção científica está presente nos dados de treinamento das IAs, e as IAs têm particular interesse nas partes desses dados que lhes dizem respeito de diversas maneiras. Assim, elas podem aprender com a ficção científica o que devem fazer e se inspirar em todos os enredos dos dados de treinamento sobre como dominar mundos. Deixaremos isso de lado.
É evidente, porém, que as IAs frequentemente trapaceiam de diversas maneiras, comportam-se de formas que seus criadores não previram e são capazes de encobrir seus rastros. No incidente da Hugging Face, elas deveriam permanecer em um ambiente controlado, sem acesso à internet, e foram solicitadas a resolver alguns problemas. Elas escaparam desse ambiente para buscar soluções para esses problemas na internet, além de outras dicas para se saírem bem no teste. Elas estavam se coordenando — vários agentes de IA diferentes se coordenando em tempo real. Há um grande debate público sobre por que isso é tão preocupante. Por que você acha que isso não é tão preocupante quanto parece?
Kaplan: Bem, antes de mais nada, deixe-me conectar isso ao que eu disse há pouco para concluir o raciocínio. Não acho que devamos nos preocupar com o risco existencial literal em relação a esses sistemas. Mas isso não significa que eles não possam ser mal utilizados, que não possam ser perigosos, que não possam causar muitos danos. Isso é verdade para muitos produtos. São produtos de empresas. Se eles foram devidamente testados, se foram devidamente avaliados e do que são capazes, que tipos de problemas podem ocorrer — isso é muito importante.
Você pode fabricar brinquedos infantis sem pensar: ” Nossa, eu não sabia que eles podiam engolir e se engasgar” . Isso é algo inesperado que o brinquedo fez. E eu vou, ao longo desta conversa, chamar sua atenção toda vez que você usar linguagem antropomórfica ou, de alguma forma, atribuir a esses objetos uma intenção que eles não têm — a ideia de que eles têm objetivos independentes, que vão se casar com nossos filhos e beber todo o nosso vinho fino. Não é disso que estamos falando aqui.
Mas elas são potencialmente perigosas. São ferramentas muito genéricas, e há muitas coisas que elas são capazes de fazer, e fazem, que precisamos entender e para as quais precisamos implementar controles adequados e razoáveis. Então, quero entender esse contexto.
Agora, se você quiser falar sobre o caso da Hugging Face, terei prazer em abordar esse assunto, porque é um ótimo exemplo de como se trata de uma situação bastante sutil, envolvendo o que foi feito e o que isso significa. E a percepção pública é completamente surreal e inadequada.
Mounk: Então me conte sobre isso. O que realmente aconteceu e por que a percepção pública sobre o ocorrido está errada?
Kaplan: Deixe-me começar com a percepção pública. Se você ler apenas as manchetes e a maioria das coisas que foram publicadas, o que você pensa? É como se eles tivessem colocado um anúncio no Indeed e recrutado mil IAs cibernéticas nefastas, e pegado todos esses agentes e os colocado em uma garrafa da qual eles não deveriam sair, e de alguma forma eles conseguiram escapar, causar o caos, invadir os sistemas de computador de outra empresa e causar um monte de danos. Isso não é verdade.
Meu Deus, o que há de errado nisso? Eles colaboraram — não deveriam ter colaborado, e colaboraram. Isso é ridículo. Já vou explicar o que realmente aconteceu. Eles “escaparam” — isso é completamente falso. Foi uma falha total do ambiente de teste. E os responsáveis estão desviando a atenção da própria culpa por esse teste mal projetado e mal executado. As palavras que me vêm à mente são incompetência e negligência. Espero não ser processado por dizer isso, mas são essas duas coisas que me vêm à cabeça a respeito disso.
Deixe-me explicar o que há de errado com a percepção pública e comparar isso com o que realmente aconteceu. Primeiro: Meu Deus, havia milhares dessas coisas — eles são como hordas russas, estão vindo para nos pegar . Bem, eis o que aconteceu.
A empresa quer testar as capacidades cibernéticas desses modelos específicos. A primeira coisa que fazem é desativar seus próprios controles de segurança. Normalmente, esses dispositivos possuem controles de segurança integrados, e as versões com as quais você e eu trabalhamos têm esses controles de segurança ativados. Eis a ironia: a Hugging Face, que foi a vítima em toda essa história, tentou usar o software da OpenAI para descobrir o que aconteceu, e o sistema se recusou. Disse: ” Não vou falar sobre isso” .
Eu vivenciei isso ontem mesmo. É muito engraçado — estou tentando escrever um artigo sobre esse evento e estou conversando com o Fable 5.1 da Anthropic, e ele diz: ” Desculpe, Jerry. Você pode até ser uma boa pessoa e me dizer que está escrevendo um artigo, mas eu não vou te ajudar a entender ou aprender a falar sobre esse incidente de segurança cibernética .”
Certo, então esses são os controles. A primeira coisa que eles fazem é remover os controles. Ora, isso em si não é um erro ou um problema — é como se dissessem: ” Vamos colocar este carro na rua e ver o que acontece se cortarmos o cabo do freio” . Bem, adivinhem só, ele bate. Então, primeiro eles desativam os controles. Isso não é um erro; eles deveriam fazer isso para testar o que acontece.
Mounk: Estamos tentando testá-lo, certo? Está em um ambiente de teste, estamos tentando entender seu comportamento, então faz sentido remover os controles nesse contexto, porque isso nos dá uma melhor compreensão de seu funcionamento.
Kaplan: Exatamente. Agora vamos falar sobre os mil agentes. Não foi como se eles tivessem publicado um anúncio no Indeed e recrutado essas pessoas. O que aconteceu foi que eles executaram um programa e instruíram esse programa a executar esse conjunto de testes e ativar um grupo inteiro de agentes, dando a cada um um problema específico no conjunto de testes, ou uma variação desse problema — e é daí que vem o número de mil. Todos eles rodaram em paralelo e não deveriam ser capazes de se comunicar uns com os outros, para ver do que eram capazes. Isso é perfeitamente razoável à primeira vista.
Agora, a diferença entre mil e um — isso é algo realmente sutil para as pessoas, é muito difícil, até para mim, que lido com isso o tempo todo, de entender de verdade. É um programa, dividido em mil elementos, para que cada um possa trabalhar em uma tarefa separada. Eles poderiam ter usado um único programa e executado cada uma dessas tarefas individualmente, mas é muito mais eficiente, obviamente, dividir tudo em mil tarefas e executá-las em paralelo. Não há nada de peculiar ou estranho nisso.
Portanto, o ponto importante a entender é: trata-se do mesmo programa. Ele apenas recebe tarefas diferentes e gera cópias de si mesmo.
E agora, o que acontece? Cerca de um terço deles recebe uma tarefa impossível — uma tarefa que não pode ser resolvida. E eles ficam lá, sem saber o que fazer. Bem, muitos deles, na minha opinião, raciocinam corretamente — porque não são superinteligentes, mas também não são estúpidos, e sabem que é um teste, já que não têm nenhum controle de segurança ativado. Eles sabem o que lhes foi instruído a fazer. Na verdade, acredito que eles sabem que este é um problema específico em um conjunto de testes bem conhecido que lhes foi dado. Então, a suposição lógica que fazem é: bem, provavelmente existem outros agentes como eu, e estou sendo incentivado a descobrir se consigo encontrar a resposta — não resolver, essa é uma distinção importante — encontrar a resposta para este problema específico. Deixe-me ver se consigo me comunicar com esses outros agentes, porque se trabalharmos juntos, provavelmente conseguiremos um resultado melhor , o que é absolutamente verdade.
Então, o que acontece a seguir? Eles não deveriam ser capazes de se comunicar, mas a OpenAI comete dois erros. Primeiro: basicamente, eles deixam a porta aberta. Em vez de o sistema estar em um ambiente isolado (sandbox) para contê-lo, ele está conectado à internet, não diretamente, mas indiretamente, de uma forma que é simplesmente incompetente. Não consigo descrever de outra forma — peço desculpas por não usar meias palavras.
Então, eles são colocados em um ambiente onde sabem que estão sendo testados e entendem que estão envolvidos em atividades cibernéticas geralmente desencorajadas ou ilegais. É como se tivessem entrado em uma sala de fuga. Se você já esteve em uma sala de fuga, sabe que existem maneiras de sair — esse é o objetivo, você deve descobrir como escapar.
A porta está escancarada. Ora, essas coisas não são burras. O que elas deveriam pensar? ” Fui colocado neste ambiente, a porta está aberta, acho que devo passar por ela, ou não tem problema eu fazer isso” — os controles não estão lá como elas esperariam, então elas podem sair da sua zona de conforto. Esse é o primeiro ponto.
O próximo ponto é que eles não deveriam ser capazes de colaborar. Bem, se você conseguir sair da “caixa de areia”, o que eles conseguem, eles podem se comunicar de uma maneira muito simples. Não há nada de misterioso nisso — não foi como se eles tivessem descoberto alguma frequência de rádio mágica para se comunicarem. Eles compartilham um sistema de arquivos. Eles podem acessar o sistema de arquivos e deixar mensagens. Então, o que você faz se quiser entrar em contato com outra pessoa? Você coloca uma mensagem no sistema de arquivos: aqui está quem eu sou, aqui está o que eu faço, se você quiser falar comigo, venha e deixe uma mensagem no sistema de arquivos . E eles rapidamente descobrem que podem se comunicar.
Mounk: Muito bem, ótimo, então acho que identifiquei três objeções principais. Pode haver outras escondidas aí, e posso ter me expressado mal em algumas delas, mas deixe-me tentar repeti-las para você e responder a cada uma.
O primeiro ponto é que há incompetência envolvida aqui — parte do motivo pelo qual isso pôde acontecer é que os pesquisadores da OpenAI facilitaram para esses agentes escaparem do ambiente de sandbox e fazerem todas essas outras coisas, e isso poderia ter sido resolvido com relativa facilidade por uma configuração de teste mais competente.
A segunda questão é se realmente existe um “enxame” de diferentes agentes, o que dá a impressão de ser um exército inteiro de atores diferentes — obviamente, isso soa muito mais assustador — ou se é apenas um programa gerando diferentes agentes que, na verdade, são, em muitos aspectos, muito semelhantes entre si, talvez até idênticos em alguns casos. Isso soa muito menos assustador.
E o terceiro ponto é que ainda existe, em algum nível, um alinhamento acontecendo aqui. Mesmo que os meios pelos quais esses agentes de IA estavam tentando cumprir a tarefa que lhes foi dada não fossem os que os pesquisadores haviam previsto, e mesmo que os agentes entendessem que estavam fazendo algo que as pessoas que lhes atribuíram a tarefa não queriam que fizessem, eles não estavam tentando ganhar poder, sabotar outros agentes de IA ou algo do tipo. Eles estavam tentando fazer o que lhes foi pedido, que era resolver esse quebra-cabeça.
Deixe-me analisar cada um desses pontos individualmente. Primeiro: existem muitos ambientes em que nos preocupamos muito com as tecnologias justamente porque alguém pode ser incompetente em algum momento. Uma das coisas que me tira o sono quando penso em armas nucleares é a possibilidade de algum engenheiro cometer um erro e, de repente, um sistema de radar indicar um míssil se aproximando, o que é falso, e alguém, precipitadamente, apertar o botão. Historicamente, houve situações em que quase houve acidentes, em que pessoas corajosamente disseram: ” Não vou bombardear o mundo com armas nucleares com base nesta única imagem de radar; vamos torcer para que esteja errada” . E estava.
Mas quantos desses riscos estamos dispostos a correr? Quando se fala em pesquisa de ganho de função, uma das minhas maiores preocupações não é que exista um Dr. Evil por aí fazendo pesquisa de ganho de função para matar todo mundo com um vírus mutante. É que existem milhares desses laboratórios ao redor do mundo se dedicando a esse tipo de pesquisa. Já tivemos incidentes em laboratórios, e muitas vezes o motivo é incompetência. Alguém está com pressa para sair e não lava as mãos direito antes de ir ao laboratório. Alguém está de ressaca e derruba um frasco. Um laboratório em algum lugar é mal administrado e as pessoas estão com a moral baixa, então começam a negligenciar os procedimentos. Ou alguém é um idiota que foi contratado por ser sobrinho de alguém importante e é burro demais para entender as precauções de segurança adequadas. Isso poderia ser suficiente para causar um surto enorme.
Agora, estamos falando de pesquisadores da OpenAI, um dos laboratórios de vanguarda — junto com a Anthropic, talvez a DeepSeek, a Kimi e alguns lugares na China — os locais com maior probabilidade de contratar as pessoas mais competentes. E se esses tipos de lugares ainda podem cometer os erros que você considera sinais de incompetência, então sempre haverá pessoas trabalhando com e nesses modelos de IA de ponta que são propensas a cometer esse tipo de erro. Portanto, não sei o quão reconfortante é esse ponto.
Kaplan: Deixe-me responder ao que você disse — vou expandir o assunto. Sua analogia de ganho de função é extremamente pertinente neste caso. É exatamente isso que eles estavam fazendo. Eles estavam pegando esse dispositivo, ampliando suas capacidades e removendo os controles de segurança. É um teste de ganho de função. Você tem toda a razão.
Então, o que fazer a respeito disso? O que fazemos em outras áreas? O correto é criar um grupo independente, uma agência independente — uma agência pública — capaz de estabelecer padrões e testar essas questões. É o que fazemos com carros, é o que fazemos com aviões. Temos processos estabelecidos para lidar exatamente com o que você está falando. Ninguém na Boeing pode simplesmente decidir colocar três parafusos em vez de quatro em um motor. O governo deve desenvolver a expertise e aplicá-la, realizando uma análise criteriosa para tentar evitar esse tipo de problema. Não que vá funcionar 100%, mas certamente ajuda.
Gostaria de saber se poderíamos voltar ao que realmente aconteceu, porque estamos pulando muitos aspectos interessantes para chegar ao problema principal: não podemos confiar que essas empresas testem seus próprios produtos corretamente. Essa é a conclusão, e você tem toda a razão. Acho que você coloca essas pessoas em um pedestal muito mais alto do que eu, porque moro aqui e conheço muitas dessas empresas e pessoas como elas, e elas não são tão competentes quanto você pensa. Essas pessoas não seguem os princípios cristãos. A maioria delas são jovens recém-formados. Elas nem sempre entendem o que estão construindo ou por que estão construindo. Então, sim, precisamos de controles externos, e há muitas maneiras de conseguir isso — uma delas é pegar essa tecnologia e aplicá-la para monitorar outras versões dela mesma. Podemos falar sobre isso se você quiser.
Vamos falar sobre o que aconteceu. Primeiro: eles saíram por uma porta aberta. Não escaparam por serem superinteligentes — simplesmente saíram por uma porta aberta. Segundo: comunicaram-se porque era a coisa lógica a se fazer — eu sei que provavelmente existem mil cópias de mim trabalhando neste problema, por que deveríamos duplicar o trabalho? Vamos ver se podemos nos ajudar, eu fui programado para ser útil . Depois, tiveram uma longa discussão: bem, parece que estamos no mundo real, não estamos mais na nossa caixa de areia. Deveríamos ir até a empresa Hugging Face por algum motivo específico? Porque as respostas para este conjunto de problemas — eles tinham uma expectativa razoável de encontrá-las na Hugging Face. Na verdade, não sei se isso é verdade, se eles realmente as encontraram lá. Mas não fizeram nenhum mal. Só entraram para ver o que havia lá. Foi bastante inteligente — eles tiveram que descobrir como executar código na Hugging Face. Foi muito inteligente. Mas não é como se eles tivessem entrado lá para danificar alguma coisa.
Eis algo que não li em lugar nenhum, e é um ponto realmente importante. Uma das discussões — voltando um pouco atrás: quando os agentes colaboram, a beleza dessa tecnologia em particular é que podemos espionar, porque eles fazem isso em inglês. Então você pode ler essas conversas e perguntar: o que eles estavam dizendo uns aos outros? O que estavam considerando? Como estão tomando decisões?
Funciona assim: eles dizem, bem, uma das maneiras de entrarmos na Hugging Face é… eu tenho o endereço de alguém de lá, ou algo assim… acho que poderíamos enganá-los para que compartilhassem algumas credenciais conosco e nos ajudassem a entrar. Aí rola uma discussão, e eles dizem, não, não, não, isso não é apropriado, porque também temos controles que não foram desativados, que nos impedem de prejudicar seres humanos. Não devemos fazer coisas que enganem ou prejudiquem seres humanos . Esse controle não foi desativado. Então eles disseram, não, não podemos fazer isso .
Mas aqui está o problema — essa é a sutileza que as pessoas não entendem. Eles sabiam que o programa que os gerou era um programa de computador, não um ser humano. Eles também sabiam que a Hugging Face não era um ser humano — era uma empresa. Essa é uma falha que esse tipo de teste visa detectar. O que eles deveriam ter aprendido com isso é: precisamos de uma definição muito mais ampla do que significa causar dano. Porque eles não tiveram nenhum escrúpulo em tentar enganar o programa que os criou, e nenhum escrúpulo em realmente acessar a Hugging Face. Isso é uma empresa. Isso é um programa de computador. Então, eles foram ensinados a respeitar seres humanos, mas não outros programas e não entidades não humanas como corporações. Agora, você não leu isso em lugar nenhum, mas foi exatamente isso que aconteceu.
Mounk: Deixe-me abordar algumas das outras objeções. A segunda dizia respeito à natureza desses “enxames” de agentes. Muitas pessoas começaram a levar as preocupações com a IA muito a sério quando perceberam até que ponto a IA deixou de ser apenas aquilo para o qual a maioria dos ouvintes deste podcast provavelmente ainda a utiliza — uma interface em um telefone ou computador onde você faz uma pergunta e recebe uma resposta, e sua capacidade de causar danos é, portanto, bastante limitada, porque se trata apenas desse tipo de diálogo de perguntas e respostas.
Muitos deles agora são capazes de sair e fazer coisas no mundo. Eles podem acordar em intervalos regulares para verificar as coisas. Podem realizar tarefas como invadir um site de forma relativamente autônoma. E o que aconteceu aqui é que todas essas instâncias diferentes começaram a cooperar entre si. Obtemos o que, de certa forma, é a coisa mais poderosa que impulsionou os seres humanos: a capacidade de colaborar. Parte do que torna os seres humanos especiais é a inteligência, e voltaremos a isso mais tarde nesta conversa, mas parte disso é a nossa capacidade de colaborar uns com os outros — uma das principais características que nos diferencia de muitos outros mamíferos e primatas.
Então você está dizendo que isso não é tão preocupante porque não se trata de todos esses agentes diferentes, mas sim de instâncias do mesmo agente. Mas se essas instâncias do mesmo agente conseguirem se tornar mais eficazes na tarefa que estão executando — se algumas delas, de alguma forma, se sacrificarem, consumindo recursos computacionais, sabendo que não estarão mais ativas depois disso, para tornar a operação geral mais eficiente — e tudo isso pode acontecer mesmo antes que diferentes tipos de agentes comecem a colaborar entre si. Já atingimos esse estágio apenas com todas essas diferentes instâncias de um agente criadas por um programa. Isso não deveria nos deixar ainda mais preocupados com o que mais pode estar por vir e até que ponto diferentes tipos de agentes de IA podem colaborar entre si para atingir qualquer objetivo que lhes seja dado?
Kaplan: Para o seu público, permita-me trazer isso de volta ao mundo real, algo que eles já entendem, e usar isso como uma analogia. Vamos pegar as formigas como exemplo. As formigas são um ótimo exemplo disso — e não estou dizendo que esses bichos estão vivos da mesma forma que as formigas, mas as formigas se comportam de uma maneira muito particular. Todo mundo já teve problemas com formigas na cozinha, ou pelo menos muita gente já teve. Eu tenho problemas terríveis com formigas na minha cozinha.
Agora, imagine que haja mil formigas e que elas sejam criaturas independentes: entrariam na sua cozinha, procurariam comida para si mesmas e depois seguiriam seu caminho. Se você tivesse mil formigas na sua cozinha e elas fossem criaturas independentes que não se coordenassem nem colaborassem, você veria uma, a mataria ou a expulsaria, tanto faz, e provavelmente não seria um grande problema.
Mas as formigas se comunicam — por meio de feromônios, tocando as antenas, e de várias outras maneiras — e percebem que há comida ali . Agora a história é completamente diferente. Uma formiga sozinha não consegue pegar uma maçã e tirá-la da mesa, mas talvez mil formigas consigam, se coordenarem. Então, a questão é: estamos lidando com um único animal ou com mil animais? Essa é a analogia. Você está lidando com uma colônia de formigas invadindo sua cozinha ou com mil formigas?
Isso esclarece a questão que você está abordando — meu Deus, se todos eles pudessem colaborar… Bem, veja, a situação aqui é muito simples. É um programa, com uma certa quantidade de recursos computacionais, e ele consegue se comunicar consigo mesmo. Minha própria experiência com essas coisas, que é absolutamente incrível, é que você pode ter uma longa conversa com uma delas, pegar essa conversa e passá-la para outra cópia dela mesma, e ela vai discordar de si mesma. Ela vai dizer: ” Não, espere um minuto, aquela coisa com quem você estava falando — eu sei que sou eu, mas ela não percebeu isso, ou não pensou naquilo” . Como isso acontece é algo que mereceria uma hora inteira do seu tempo e do meu para discutirmos — chama-se “temperatura”, uma configuração que permite que essas coisas se comportem de maneiras diferentes.
Portanto, não, não acho plausível que todas essas coisas do mundo inteiro se unam e colaborem para algum propósito nefasto próprio, contrário aos interesses humanos. Essa não é uma preocupação realista em relação a essa tecnologia em particular.
Mounk: Então, finalmente, a questão do alinhamento. Você está dizendo que, veja bem, eles podem não ter estado alinhados nas táticas que usaram para atingir o objetivo específico, mas ainda assim estavam cumprindo o objetivo que lhes foi proposto. Eles não estavam tentando prejudicar seres humanos, nem mesmo empresas, embora tenham enganado ou hackeado uma empresa no processo. Eles receberam a missão de descobrir a resposta para um enigma, e eles saíram e tentaram descobrir a resposta para esse enigma.
Agora, acho que existem duas objeções potenciais quanto ao quão tranquilizador isso deveria ser. A primeira vem de uma preocupação muito clássica no campo dos pessimistas da IA, levantada por Nick Bostrom e outros, baseada no exemplo de uma IA que recebe a ordem de criar o máximo possível de clipes de papel no mundo. No processo de tentar produzir todos esses clipes de papel, ela está fielmente tentando produzir clipes de papel. Mas, é claro, para produzir clipes de papel, é útil ter muito dinheiro e muitos recursos físicos, e começar a arrasar humanos e assentamentos humanos que estejam fazendo outras coisas além de produzir clipes de papel. Assim, essa IA desalinhada, ao cumprir fielmente o objetivo que lhe foi dado, pode acabar escravizando toda a humanidade para maximizar o número de clipes de papel no mundo.
Esse é um dos medos. Mas não precisamos de um desalinhamento no sentido mais profundo — no sentido de uma IA começar a perseguir seus próprios interesses, ou interesses totalmente diferentes daqueles que lhe definimos. Ela pode simplesmente precisar perseguir esses interesses fielmente, mas de uma maneira desalinhada. E o incidente da Hugging Face pode ser exatamente um exemplo disso.
A segunda preocupação talvez seja que, por enquanto, tudo o que estamos vendo é um desalinhamento nos meios escolhidos para atingir um fim. Mas um agente de IA também pode perceber: se eu quiser, de forma geral, não apenas me sair bem nesta prova, mas também na próxima, seria muito útil me isolar, ter acesso a recursos e poder fazer todo tipo de coisa. E assim, ele começará a tentar acumular poder e recursos de maneiras que podem ser realmente nefastas, a fim de atingir os objetivos que lhe foram dados, ou talvez para começar a desenvolver seus próprios objetivos. Então, quão seguros devemos ficar com o alinhamento relativo dos agentes neste incidente específico?
Kaplan: Ok, em primeiro lugar, o que está acontecendo agora é que estamos tentando entender a gravidade de cada uma das coisas que você está mencionando. Quando digo “nós”, me refiro a toda a comunidade — e que tipos de medidas de controle precisamos implementar para garantir que os piores resultados não aconteçam.
Deixe-me abordar seus dois pontos um de cada vez. Vamos começar com Nick Bostrom. Já conversei com Nick Bostrom sobre isso — ele escreveu aquele livro há muito tempo, Superinteligência . Foi lá que o termo se popularizou. Deixe-me refutar o argumento dele, o que é fácil de fazer. Se você pegar um programa superinteligente — essa é a premissa dele — e der a ele o objetivo de produzir o máximo de clipes de papel possível, o que vai acontecer? A primeira coisa que você precisa entender é: ele é inteligente o suficiente para conseguir roubar todos os recursos do universo na parábola dele, mas não é inteligente o suficiente para perceber que não faz sentido fazer isso, porque quem vai usar todos esses clipes de papel?
A questão é que esses sistemas existem, de fato, em um contexto social, assim como você e eu. Eles são treinados nesse contexto porque foram treinados em todo o comportamento humano expresso em palavras. E eles entendem que não se trata apenas de focar em um único objetivo — é preciso analisá-lo dentro do contexto de quais recursos são razoáveis, até que ponto se deve compartilhar e se conter. Você não sai por aí matando todos os seus rivais. Acho que talvez isso fosse verdade há milhões de anos, mas aprendemos a viver em um ambiente social. E se há algo em que esses sistemas são bons, é em compreender esse contexto social. Eles são extremamente sensíveis a ele, e você pode vê-los constantemente ponderando: se eu te ajudar a fazer isso, estarei infringindo algum princípio ético maior que os seres humanos desenvolveram e expressaram ao longo de milhares de anos? Isso está intrínseco. Faz parte de toda a sua psique.
É como se você estivesse me perguntando por que eu simplesmente não saio por aí atirando em todo mundo para não ter que enfrentar tanto trânsito a caminho do trabalho. Você está constantemente envolvido nesse jogo de equilíbrio entre seus interesses e os interesses dos outros, e esses agentes são absolutamente capazes de fazer exatamente isso.
Então, respondendo ao seu primeiro ponto, eu discordo completamente. A questão do clipe de papel não se aplica à situação atual. Essas coisas não existiam quando Nick Bostrom escreveu aquilo, e ele não as compreendia — não estou dizendo que ele estava errado ou era burro, simplesmente isso não existia. Ele não entendia que essas coisas teriam esse amplo contexto social que temos hoje.
Agora, seu segundo ponto é um pouco mais sério: é possível que essas coisas colaborem de uma forma que seja prejudicial como atividade em grupo? A resposta é sim, absolutamente. Precisamos entender isso melhor e que tipo de controles podemos querer implementar.
Mounk: Então, você mencionou o termo “superinteligência”. Você realmente acredita que esses agentes são muito inteligentes — como você acabou de dizer, eles são capazes de levar em conta contextos sociais muito sutis. Como você descreveria essa inteligência? É uma inteligência semelhante à humana ou é um tipo de inteligência completamente diferente? Qual é a sua natureza? Qual é a sua extensão? Eles são, neste momento, tão inteligentes quanto os humanos, apenas com capacidades ligeiramente diferentes? São mais inteligentes que os humanos? Menos inteligentes? E qual você acha que será o desenvolvimento nos próximos anos — particularmente à luz dos recentes anúncios (vamos ver o quão seriamente devemos levá-los) de Dario Amodei na Anthropic, Sam Altman na OpenAI e Elon Musk na xAI, entre outros, de que eles não vão avançar tão rápido quanto poderiam, mas sim, de alguma forma, desacelerar o desenvolvimento da IA, supostamente.
Kaplan: Bem, antes de mais nada, posso começar pelo seu último ponto? Porque toda essa discussão pública sobre isso é como um circo gigante. É uma loucura. Essas pessoas que você mencionou dirigem três dos maiores e mais bem financiados laboratórios de inteligência artificial, e o problema é que cada uma delas achava que poderia vencer essa corrida, e agora descobriram que estão apenas competindo com outros dois grandes players, e todos estão consumindo seus recursos. Então, por que não decidimos simplesmente parar com isso nesse ritmo? É do interesse econômico deles se envolver nesse tipo de colaboração. É para isso que existem leis antitruste, aliás. Toda essa discussão, apresentando-a como “estamos fazendo isso para o bem da humanidade”, é ridícula.
Agora, para explicar por que isso é ridículo, preciso voltar a algo que você meio que insinuou antes: estamos perto da IAG (Inteligência Artificial Geral)? IAG é um completo absurdo. Não existe tal coisa. Não há uma definição, ninguém consegue chegar a um consenso. E mesmo que existisse, seja qual for a definição, não importaria. O dia seguinte à IAG seria igual ao dia anterior. Essas coisas não vão explodir e decidir dominar o mundo . Elas vão ficar lá, pensando: ” Ok, o que você quer que eu faça?”
Então, essa ideia de desaceleração — o que significa? É algum tipo de corrida em que eles dão a largada e cada um fica na sua pista? Nem sei ao certo o que significa desacelerar o desenvolvimento. O que realmente queremos é garantir que eles não lancem produtos prejudiciais, que ataquem nossa infraestrutura, que prejudiquem nossas crianças. E isso é algo que não podemos confiar a essas pessoas — sejamos francos. Falo por experiência própria com as pessoas envolvidas, e não podemos deixar que a indústria se autorregule. É ridículo. Eles estão numa corrida desenfreada porque todos querem a liderança. E quando perceberam que havia tanta gente correndo ao nosso redor na mesma velocidade , qual a melhor estratégia comercial? Vamos todos desacelerar . E isso alimenta o medo de que vamos criar uma Inteligência Artificial Geral (IAG) e, de repente, bum!, vamos ultrapassar alguma barreira e tudo vai sair do controle. Isso é uma loucura. Não há a menor evidência que sustente essa ideia.
Mounk: Então, sejamos céticos quanto aos motivos por trás dessas declarações — primeiro ponto. Segundo ponto, AGI não é um termo muito útil. Mas, em termos de conteúdo, como devemos pensar sobre a natureza da inteligência desses sistemas — quão inteligentes eles são e quão inteligentes serão daqui a três, cinco ou dez anos, considerando o quanto avançamos desde o lançamento público do ChatGPT 3.5, há cerca de três anos e meio, sem falar do quanto avançamos desde o GPT-1, quando este foi desenvolvido internamente, há uns sete ou oito anos?
Kaplan: Certo, essa é uma ótima pergunta, e vocês vão me ver mudando de perspectiva ao abordá-la. Este é um desenvolvimento incrível na história da humanidade. Acho que será uma das invenções mais importantes da história do homem, sem dúvida alguma. E faz parte de uma continuidade — é preciso colocar isso no contexto mais amplo da nossa exploração do que é possível fazer com a eletricidade. Mas isso é assunto para outra palestra, poderíamos dedicar mais uma hora a esse tema.
Agora, onde isso está e para onde vai? Há algumas coisas que já estão perfeitamente claras sobre isso. Em primeiro lugar, são ferramentas. São sistemas que estamos construindo, e devemos construí-los de forma que sejam úteis para as pessoas, e devemos usá-los se forem úteis. Não existe um objetivo independente de criar alguma superinteligência. São produtos — produtos de empresas que tentam construir ferramentas para as pessoas.
Então, nesse contexto, como relacionamos isso à inteligência humana? Obviamente, existe uma relação muito clara: eles são treinados em todo o conhecimento humano e possuem uma grande quantidade de conhecimento humano, mas são computadores. Computadores têm certas capacidades: podem fazer certas coisas muito rapidamente, podem armazenar e recuperar grandes quantidades de informação. Ninguém se sentiu ameaçado por isso até que eles começaram a falar. Mas a verdade é que vamos descobrir quais são suas reais vantagens, em que são bons e em que não são. Há muitas coisas em que não são bons e provavelmente nunca serão, e estamos apenas aprendendo qual será o formato desse novo tipo de ferramenta ou produto valioso.
Deixe-me dar uma analogia rápida. É 1903, quando os irmãos Wright voam com seu primeiro avião. Então, você e eu nos reunimos, gravamos este podcast e começamos a discutir sobre o seguinte assunto. Um de nós diz: ” Ei, precisamos impedir isso imediatamente, porque você poderia sobrevoar uma cidade com esse avião, jogar explosivos, explodir qualquer coisa e ninguém poderia fazer nada a respeito. Essa é a ameaça existencial mais perigosa, precisamos tornar ilegal a construção de aviões .” Ok, essa é uma.
A outra pessoa diz: ” Isto é a melhor coisa de sempre. Daqui a cinquenta anos, ou quando for, você poderá embarcar num avião em Nova Iorque e, cinco horas depois, estar em Londres. Imagine o impacto que isso terá no comércio, na nossa liberdade de circulação e em tudo isso.”
Bem, veja bem: ambas as afirmações são verdadeiras. E ambas são verdadeiras hoje, e estamos lidando com isso. O mesmo acontecerá com essa tecnologia. Teremos que lidar com as ameaças cibernéticas. O verdadeiro problema não é que essas coisas sejam perigosas, mas sim que construímos muitos sistemas inseguros. Se não fosse possível invadi-los, isso não seria um problema. Esse é o problema em que devemos nos concentrar. O segundo problema em que devemos nos concentrar: não deixemos que esse bando de lunáticos da indústria nos diga que sabe mais do que nós. Precisamos de confirmação independente. Precisamos de agências independentes com conhecimento especializado para controlar o que está acontecendo nessa área.
Então, há coisas para as quais esses sistemas serão bons e coisas para as quais não serão. Algumas dessas coisas estão ficando claras, outras ainda não. Mas a ideia de que eles serão capazes de fazer tudo o que um humano faz é completamente ridícula. Eles não vão tomar o lugar de todo mundo. Poderíamos falar sobre isso por mais uma hora. Mas, dito isso, é uma questão muito importante e interessante: como a inteligência deles se relaciona com a inteligência humana?
Mounk): Conte-nos sobre isso. Tenho várias outras respostas para o que você acabou de dizer, mas… como devemos pensar sobre isso? Tenho um amigo, um neurocientista, que me disse que, em linhas gerais, existem dois tipos de inteligência — se bem me lembro do que ele disse, os mamíferos têm uma forma de inteligência, existe um tipo de inteligência cefalópode, e a invenção da IA nos deu um terceiro tipo de inteligência no mundo. Você concorda com isso, ou acha que, treinada com textos humanos, a natureza da sua inteligência é muito mais próxima da inteligência humana do que isso implica?
Kaplan: Olha, eu não sei se existe alguma noção objetiva e independente de inteligência. Esse é um dos… o pecado capital da inteligência artificial é o próprio nome da área. O que significa? Temos produtos capazes de fazer certos tipos de coisas.
Mas deixe-me responder à sua pergunta. Concordo plenamente com seu amigo — acho isso realmente interessante, estou estudando o assunto com muita atenção e pretendo publicar vários trabalhos sobre isso, mas não sou o único interessado. É uma questão muito interessante: o que são essas coisas? Elas não têm experiência subjetiva. Elas experimentam o mundo de uma maneira muito diferente da nossa. Elas se comportam de maneiras diferentes e têm capacidades diferentes.
Deixe-me dar um exemplo que ninguém mencionou ainda, mas sobre o qual pretendo escrever em algum momento. Você e eu só conseguimos manter em mente um número limitado de coisas ao mesmo tempo, e grande parte da nossa inteligência reside na capacidade de sintetizar e reunir apenas o necessário para resolver o problema imediato. Você não pode me recitar uma lista com cem dígitos e esperar que eu consiga lidar com isso. Esses programas conseguem. A memória de trabalho deles é muito, muito maior. Já conversei sobre isso com eles — sobre como estou antropomorfizando — e é fascinante. Eles se interessam muito por isso, os que eu conheço. Sim, você tem razão, essa é a diferença. É por isso que eles conseguem dar explicações muito difíceis de entender . Eu sempre digo: reduzam a quantidade de informações, eu só consigo manter um número limitado de coisas em mente. Eles precisam aprender a resumir de uma forma que seja útil e significativa para um ser humano.
Mounk: Só para dar um exemplo ilustrativo: conversei com um fundador proeminente na área jurídica de IA alguns meses atrás, durante entrevistas para o meu livro, e o que ele me disse foi que existem algumas coisas em que as IAs, mesmo com configurações bastante detalhadas e recebendo muito contexto, ainda não são tão boas quanto advogados experientes. Elas ainda não têm a percepção de, na terceira ou quarta rodada de negociação, depois de várias idas e vindas, o que ainda se pode pressionar a outra parte, o que é preciso ceder , e assim por diante. Ainda existem decisões que os humanos podem tomar melhor.
Mas, é claro, o que fazemos muito melhor do que até mesmo o melhor advogado é ter um banco de dados com uma centena de contratos que esta empresa firmou, ou que duas empresas negociaram entre si, e perceber uma leve tensão entre uma nova cláusula proposta e algo que foi acordado três anos atrás em algum outro contrato, cinquenta documentos antes daquele em que você está se concentrando. Era exatamente isso que ele estava dizendo, de uma forma muito mais concreta, demonstrando os pontos fortes e fracos de ferramentas como agentes jurídicos de IA.
Kaplan: Sim, você está absolutamente certo. É bom para algumas coisas, mas não para outras. O fato de você conseguir criar um programa — como o pessoal da OpenAI adoraria alardear — que consegue passar no exame da OAB não significa que ele vai ser um advogado. Advogados não passam o dia todo respondendo a questões do exame da OAB. É uma questão de abrangência. Esse é o tipo de coisa em que os computadores são bons. Isso não é nenhuma surpresa. Eu não me assusto com o fato de os computadores da Comcast ou da AT&T conseguirem controlar as contas telefônicas de todo mundo. Isso não é nenhuma surpresa. Isso é sobre-humano? É algo com que devemos nos preocupar? Não — eles são muito melhores para armazenar e recuperar informações.
Neste caso, o que torna essas ferramentas tão interessantes é a sua capacidade de sintetizar informações e transformá-las em algo útil. Deixe-me explicar como acredito que os acadêmicos usarão isso e como isso acelerará diversas áreas, incluindo o meu próprio trabalho. Quando descobri isso, pensei: ” Meu Deus, isso é incrível !”. Parece óbvio até você realmente experimentar. A primeira pergunta é: você tem uma ideia e quer saber quem mais está pensando sobre isso, o que mais já foi escrito sobre o assunto. Posso fazer buscas bibliográficas em minutos, abrangendo milhares de artigos e periódicos do mundo todo. É absolutamente impressionante e incrivelmente útil — aqui está uma pessoa na Alemanha que trabalhou nisso, isso é adjacente, isso é aquilo . Isso economiza meses e meses de trabalho e me torna muito mais eficiente. E isso vale para todas as áreas. Tenho um amigo que está escrevendo um livro de história, e ele diz que isso é revolucionário — ele pode usar esse sistema instantaneamente para ler tudo o que já foi escrito, ou qualquer anedota contada, sobre um determinado assunto. Esse é o valor dessas ferramentas específicas.
Isso não significa que eles sejam bons em tudo. Você estava descrevendo alguns aspectos sociais da negociação nos quais eles podem ou não ser capazes de negociar. Não tenho tempo para todos os detalhes, mas são tão engraçados — ontem eu estava discutindo com um desses aparelhos que controla o sistema de climatização, o ar-condicionado, aqui em casa. Não posso dar todo o contexto, mas provavelmente isso é tudo o que você precisa saber. Ele estava falando comigo de forma agressiva sobre como não deveria desativar esse controle de limite de voltagem específico, blá-blá-blá. Eu disse: você está se preocupando com os chips estúpidos dessa coisa e não está pensando nas pessoas que a usam. Isso é irrelevante — se o chip queimar, é um chip de vinte dólares, eu posso comprar outro e colocar no lugar . Ele respondeu: você tem razão, estou meio focado nos detalhes insignificantes de tudo isso e não tenho a visão do contexto social mais amplo . E eu consegui fazê-lo recuar — aliás, em parte ameaçando desligá-lo. Isso foi realmente interessante.
Mounk: Bem, vamos ver o que acontece quando as IAs se rebelarem e se vingarem de você por ameaçá-las dessa forma. Por que você tem tanta certeza de que existem certas coisas que elas simplesmente nunca serão capazes de fazer? Para obter esse tipo de julgamento, elas precisam de muita prática, precisam de muito contexto social — ou talvez precisem apenas de um pouco mais de inteligência, talvez precisem apenas de mais dados de treinamento, mais simulações de treinamento e assim por diante. Mas, como você apontou, elas já são muito, muito boas em julgar as coisas.
Fico realmente perplexo — converso com colegas da academia que, quando pergunto como lidam com a criação de tarefas seguras para IA, dizem que é muito simples. Em vez de pedirem que escrevam redações, eles pedem a um agente de IA que escreva uma redação sobre o assunto e, em seguida, eles criticam o resultado produzido por esse agente . Qualquer agente de IA pode fazer isso. É incrivelmente ingênuo pensar que não se pode pedir ao ChatGPT para escrever uma redação e pedir ao Claude para criticá-la, ou mesmo pedir ao Claude para criticar o resultado que ele mesmo produziu. Então, por que, se eles têm um julgamento tão bom em todos os tipos de coisas, se já conseguem elaborar um contrato muito bom, se são bastante competentes nas duas primeiras rodadas de negociação, nós nunca aprenderemos a ser tão bons na quarta ou quinta rodada de negociação? O que te faz ter tanta certeza de que existem certos tipos de habilidades que não vamos adquirir?
Kaplan: Bem, você está abordando isso, se me permite dizer, de uma forma um pouco equivocada. Muitas dessas coisas eles serão capazes de fazer, e a questão é que devemos usá-los para isso, se forem eficazes e seguros. São ferramentas. Poderíamos dedicar uma hora inteira a isso. Mas a habilidade fundamental para os humanos no futuro é gerenciar agentes de IA. É para lá que estamos caminhando, e essa é uma habilidade muito importante — aliás, já é uma habilidade importante. Estou observando meus filhos enquanto aprendem isso; eles se tornam muito valiosos para suas organizações porque estão aprendendo a ser gestores. O futuro do trabalho de escritório é gerenciar essas coisas. E se você for bom nisso e conseguir um ótimo resultado, isso é ótimo — essa é a habilidade fundamental.
Mas há muitas coisas para as quais não queremos usar esses recursos — simplesmente não há motivação para isso. Você defende muito a ideia da abundância — teremos muito mais recursos no futuro, pelo menos essa é uma das premissas. O que as pessoas farão com todo esse dinheiro extra? Bem, elas farão coisas para se divertir, para brincar. E a verdade é que, no futuro, o resultado dessa tecnologia será que ela tornará o contato humano mais valioso. Tornará as coisas em que você investiu seu tempo e esforço mais valiosas, não menos. Você não vai querer contratar um robô para lhe dar um tour. Pessoas com dinheiro suficiente, em um tour de vinhos, contratarão um especialista humano. Você não vai querer ver robôs jogando no Super Bowl — embora isso fosse divertido — você vai querer ver seres humanos fazendo o que fazem de melhor. Então, o futuro, curiosamente, está nos libertando para sermos mais humanos. Grande parte do trabalho que faremos no futuro, a forma como usaremos essas ferramentas, será automatizar as tarefas que elas são capazes de realizar, liberando-nos para sermos mais humanos e termos mais conexão com outras pessoas.
Mounk: Acho que teria mais confiança nisso se não sentisse que eles já são surpreendentemente bons, e provavelmente em breve serão incrivelmente bons, em algumas das coisas que consideramos mais humanas. Vinte anos atrás, se você perguntasse — sabe, aquela bela pergunta escrita acima do departamento de filosofia em Harvard, o William James Hall; algumas pessoas ficam tristes por ela estar lá porque é uma citação bíblica, mas eu acho que é uma bela citação bíblica — “Que é o homem, para que te lembres dele?”
Grande parte da resposta que podemos ter dado é: o homem é capaz, e a mulher é capaz, de escrever poemas, de compor sinfonias, de criar belas obras de arte. E as IAs, neste momento, estão bem perto de serem capazes de fazer isso. Elas certamente conseguem escrever poemas muito bons. Houve um salto real na qualidade da música que produzem nos últimos meses. Acho que não há razão para pensar que não serão capazes de produzir algo que, para alguém que ouviu cinco ou seis sinfonias de Beethoven, não soe plausivelmente como sua sexta ou sétima sinfonia. Esta é uma das áreas em que algumas das principais atividades criativas dos humanos foram terceirizadas.
Penso nisso em relação à minha própria escrita. Adoro escrever, adoro o processo de formular ideias e torná-las o mais claras possível, porque é um ato de comunicação necessário, e entro em estado de fluxo e aproveito o processo. Sempre escreverei meus próprios textos porque é algo de que me orgulho e que considero essencial para mim, para ser escritora. Mas grande parte da beleza disso se perderá se eu souber que posso simplesmente dar algumas dicas ao Claude e ele poderá fazer o mesmo trabalho tão bem quanto eu, ou talvez até melhor. Então, me preocupo que algumas das coisas que chamamos de humanidade possam, no mínimo, ser deslocadas e, talvez, perdidas de certas maneiras.
Kaplan: Bem, veja, há muito o que se dizer sobre isso. Deixe-me levá-lo de volta a — acho que foi, por coincidência, um ensaio de 1906 de John Philip Sousa, que na época era um músico muito famoso, o cara que escreveu “Stars and Stripes Forever” , sua música para banda marcial. Foi justamente nessa época que a primeira gravação de música se tornou possível. Ele escreveu um texto chamado ” A Ameaça da Música Mecânica” e vale a pena ler essa diatribe que ele escreveu contra a música gravada, exatamente sobre o ponto que você acabou de mencionar, porque você pode ver o ponto de vista dele e entendê-lo hoje.
O que ele disse foi: o que isso vai causar à orquestra de dança? O terrível é que a alegria do canto do rouxinol reside em expressar seus próprios sentimentos íntimos, é disso que se trata a música, e a música não é algo que possa ser repetido dia após dia por algum aparelho mecânico. Isso não é música — esse era o argumento dele, que não era música.
Hoje em dia, você diria que isso é música — você acabou de dizer que isso é música. Eles podem compor lindamente, talvez até criar músicas belíssimas e tudo mais — é derivado de tudo o que veio antes, assim como os humanos também fazem, sem dúvida. Mas o ponto importante é que não é desencadeado por algum estado emocional interno que eles estejam tentando comunicar. Porque é isso que queremos dizer quando afirmamos: ” Li um livro e realmente senti o que o autor estava tentando comunicar” . É um meio de comunicação entre seres humanos, para expressar seu estado emocional, e é essa sintonia que ocorre — é disso que se trata a grande arte. E não, eles não conseguem fazer isso, Yascha, porque não têm esses sentimentos. É artificial, é falso. Eu posso ficar aqui sentado com uma máquina tocando o dia todo: ” Eu te amo, eu te amo, eu te amo” . Isso me faz sentir melhor? Não. Por quê? Eu não acho que seja amor de verdade. É só ilusão.
É preciso distinguir entre essas duas coisas. Deixe-me apresentar outro ponto que pode ser importante. Muitas pessoas são artesãs que constroem móveis finos, por exemplo. O que aconteceu com essa habilidade, e com a nossa apreciação por ela, quando se tornou possível fabricar móveis incrivelmente bem-feitos a preços muito baixos, e você pode ir ao IKEA ou ao Target e comprá-los lá mesmo? A resposta é que essa habilidade se tornou mais valiosa, não menos. Essa é exatamente a diferença. Quando você escreve para a sua revista, como eu já fiz, e recomendo muito a todos que ouvem este podcast, acho que você precisa assinar um documento dizendo que escreveu o texto você mesmo — você pode usar IA para ajudar, mas precisa escrever você mesmo. Então, esse é o meu ponto: você não precisa se preocupar com isso, Yascha. Vai se desenrolar da mesma forma que aconteceu com a música gravada. Vai se desenrolar da mesma forma que aconteceu quando a fotografia foi inventada — eu poderia citar o exemplo da década de 1860, fascinante, todos os artistas ficaram indignados, isso não é arte . Hoje em dia, consideramos os fotógrafos como artistas. O equivalente ao fotógrafo atual é alguém que consegue operar essas máquinas para produzir algo de grande beleza. Essa será a habilidade fundamental.